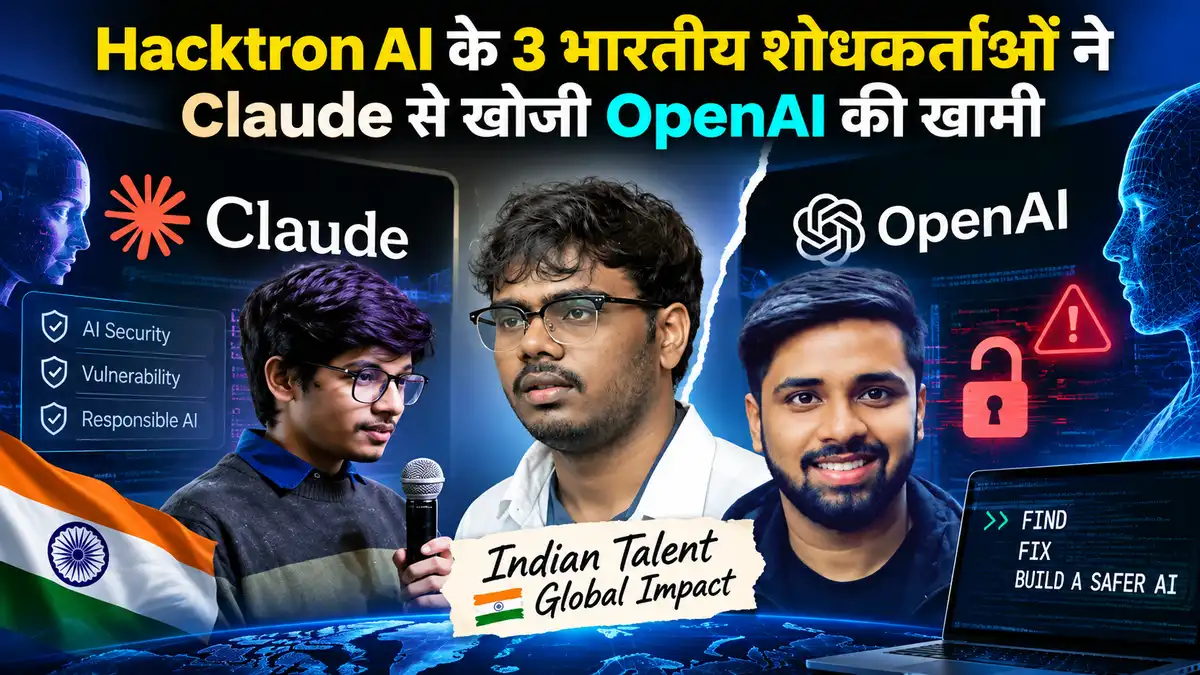
साइबर सुरक्षा स्टार्टअप Hacktron AI के तीन भारतीय मूल के शोधकर्ताओं — हर्ष जायसवाल, मोहन पेढ़पति और राहुल मैनी — ने Anthropic के AI मॉडल Claude का इस्तेमाल करके OpenAI के सिस्टम में एक गंभीर सुरक्षा खामी खोज निकाली। इस काम के बदले उन्हें OpenAI की तरफ से 6,500 डॉलर, यानी करीब ₹6.27 लाख का बग बाउंटी इनाम मिला है।
कैसे हुई पूरी खोज
Wall Street Journal की रिपोर्ट के मुताबिक टीम ने जुलाई 2026 में यह रिसर्च शुरू की थी। शुरुआत OpenAI के पब्लिक कम्युनिटी फोरम से हुई, जहां से उन्हें एक कमजोरी का सुराग मिला। इसके बाद टीम ने Discourse प्लेटफॉर्म में मौजूद एक इमेज-प्रोसेसिंग बग को एक अलग आइडेंटिटी-संबंधी खामी के साथ जोड़ा, जिससे उन्हें OpenAI कर्मचारियों के ChatGPT और Codex अकाउंट्स तक पहुंच मिल गई। आगे बढ़ते हुए वे कंपनी के एक प्राइवेट GitHub रिपॉजिटरी तक भी पहुंच गए।
पूरी प्रक्रिया, यानी शुरुआती खामी की पहचान से लेकर इंटरनल सिस्टम तक पहुंचने तक, 72 घंटे से भी कम समय में पूरी हो गई। टीम ने इस दौरान AI मॉडल टोकन पर 3,000 डॉलर से भी कम खर्च किए।
OpenAI ने क्या कदम उठाए
शोधकर्ताओं ने संवेदनशील जानकारी चुराने के बजाय एक हानिरहित पुल रिक्वेस्ट के जरिए अपनी पहुंच साबित की और तुरंत इसकी जानकारी OpenAI को दे दी। रिपोर्ट मिलने के करीब 14 घंटे के भीतर OpenAI ने पहचान से जुड़ी खामी को ठीक कर दिया और प्रभावित सेशन व ऑथेंटिकेशन टोकन को रद्द कर दिया। OpenAI के प्रवक्ता ड्रू पुसातेरी ने Forbes को दिए बयान में शोधकर्ताओं की रिपोर्टिंग के लिए धन्यवाद दिया और पुष्टि की कि खामी को दूर कर लिया गया है।
इस खबर की चर्चा क्यों हो रही है
इस मामले को खास बनाने वाली बात यह है कि जिस Claude का इस्तेमाल OpenAI के सिस्टम में सेंध लगाने के लिए किया गया, वह खुद OpenAI की प्रतिद्वंद्वी कंपनी Anthropic का मॉडल है। टेक जगत में इस पर भी चर्चा हो रही है कि तीनों शोधकर्ताओं की प्रोफाइल में किसी बड़े संस्थान या बड़ी टेक कंपनी का अनुभव नहीं है, फिर भी उन्होंने यह उपलब्धि हासिल की। यह घटना दिखाती है कि AI टूल्स अब साइबर सिक्योरिटी रिसर्च की रफ्तार को कितनी तेजी से बदल रहे हैं, जहां जटिल सुरक्षा खामियों की पहचान और टेस्टिंग पहले से कहीं तेज हो गई है।